

Apple prepara Harbor: più Mac diventano un unico server AI privato. L’applicazione, sviluppata sotto il marchio Claris, punta a semplificare l’esecuzione dei modelli AI in locale, trasformando uno o più computer Apple Silicon in un’infrastruttura di inferenza accessibile senza particolari competenze tecniche. La novità più interessante non riguarda tanto la capacità di collegare diversi Mac, quanto la possibilità di farlo senza utilizzare il Terminale, configurare manualmente le connessioni o intervenire sui meccanismi di distribuzione dei modelli.
Con macOS Tahoe 26.2, Apple ha introdotto il supporto a RDMA su Thunderbolt 5, mentre il framework MLX ha progressivamente ampliato le proprie capacità di calcolo distribuito. Abbiamo già analizzato il caso di quattro Mac Studio collegati per ottenere 1,5 TB di memoria unificata complessiva. Harbor promette di rendere molto più semplice realizzare configurazioni simili, senza affrontare le complessità che oggi accompagnano il clustering.
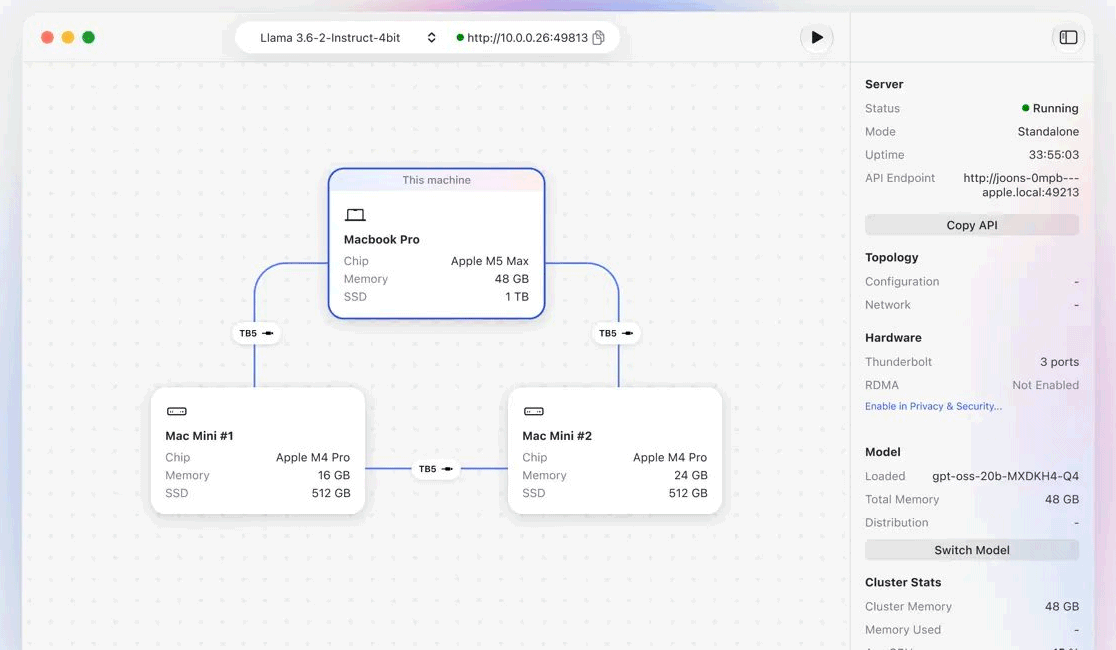
Fonte dell’immagine: Aaron su X
Harbor: un server AI privato che si configura automaticamente
Le prime informazioni diffuse in questi giorni raccontano un prodotto che non è ancora ufficialmente disponibile al pubblico: Harbor compare in una private preview, accompagnata da una pagina ufficiale Claris che ne conferma l’esistenza e illustra le funzionalità previste.
Claris, società controllata da Apple e conosciuta soprattutto per FileMaker, descrive Harbor come uno strumento capace di trasformare i Mac Apple Silicon in server privati per l’esecuzione di modelli open-weight. Il software dovrebbe consentire di cercare, scaricare e caricare i modelli direttamente dall’interfaccia grafica, senza ricorrere a comandi o procedure di installazione articolate.
Su un singolo Mac, Harbor potrebbe predisporre in pochi minuti un endpoint di inferenza, ossia un servizio al quale altre applicazioni possono inviare richieste per ottenere risposte generate dal modello. Claris ma non specifica ancora quali API saranno supportate.
Come Harbor trasforma più Mac in un’unica risorsa di calcolo
La caratteristica più ambiziosa riguarda il clustering automatico tramite Thunderbolt 5: collegando almeno due Mac compatibili, Harbor dovrebbe identificarli autonomamente e coordinare l’utilizzo della memoria disponibile sui diversi computer.
Un modello troppo grande per essere caricato sulla memoria di un singolo Mac potrebbe distribuire i propri pesi fra più dispositivi: la memoria unificata di Apple Silicon, accessibile sia dalla CPU sia dalla GPU, costituisce un vantaggio importante perché evita di dover trasferire continuamente i dati fra RAM di sistema e memoria video separata, come accade in molte architetture tradizionali.
Sommare la memoria di più Mac non significa però ottenere un unico spazio RAM fisicamente condiviso e accessibile con la stessa latenza: ogni macchina conserva la propria memoria; il software deve suddividere il modello e coordinare le operazioni tra i nodi.
La stessa tecnologia può servire anche a gestire più richieste in simultanea, migliorando la capacità complessiva del server. L’effettivo vantaggio dipende però dal modello, dal metodo di parallelizzazione e dalla quantità di dati trasferiti fra le macchine.
Il ruolo di RDMA e MLX: la complessità che Harbor vuole eliminare
Le basi tecnologiche esistono già. A partire da macOS 26.2, Apple supporta RDMA over Thunderbolt sui Mac Apple Silicon dotati di Thunderbolt 5. La tecnologia permette di trasferire dati fra le memorie di computer differenti riducendo l’intervento della CPU e i costi delle comunicazioni tradizionali.
Apple ha documentato il funzionamento nella nota tecnica TN3205: per utilizzare RDMA occorre abilitarlo; la procedura documentata prevede l’accesso all’ambiente di ripristino di macOS e l’esecuzione del comando rdma_ctl enable.
Sul versante software interviene MLX, framework Apple dedicato al machine learning: dalla versione 0.30.1 supporta il backend JACCL, progettato per sfruttare RDMA e gestire comunicazioni collettive fra diversi nodi. Secondo la documentazione tecnica, JACCL può ridurre di un ordine di grandezza la latenza rispetto alla soluzione precedentemente adottata.
Oggi MLX mette già a disposizione strumenti come mlx.distributed_config e mlx.launch, rispettivamente per preparare la configurazione dei nodi e avviare l’esecuzione distribuita: richiedono comunque familiarità con SSH, interfacce di rete, topologie e parametri di esecuzione.
Più memoria non significa sempre maggiore velocità
Thunderbolt 5 offre una larghezza di banda nominale bidirezionale di 80 Gbit/s, ma le comunicazioni fra computer restano molto più lente degli accessi alla memoria locale.
Durante l’inferenza, le GPU devono scambiare risultati intermedi e sincronizzare le operazioni: all’aumentare dei nodi possono crescere anche i tempi di comunicazione.
Inoltre, i modelli occupano memoria non soltanto per i pesi, ma anche per la KV cache (memoria temporanea che conserva le informazioni già elaborate dal modello per evitare di ricalcolarle durante la generazione del testo), le attivazioni e le strutture temporanee necessarie all’elaborazione. La quantizzazione a 4 o 8 bit può ridurre significativamente il consumo di memoria, introducendo però compromessi sulla precisione.
Harbor potrebbe quindi risultare particolarmente interessante per eseguire modelli altrimenti troppo grandi per una sola macchina. Per quelli più piccoli, invece, aggiungere Mac potrebbe non offrire benefici proporzionati ai costi.
Privacy, alternative e disponibilità
Claris insiste sulla privacy dell’inferenza locale: prompt e dati elaborati rimarrebbero sui computer dell’utente, senza invio ai servizi cloud. Una caratteristica interessante per aziende, sviluppatori e professionisti che lavorano con documenti riservati.
Harbor non è una novità in senso stretto: Exo permette già di distribuire modelli AI fra più dispositivi mentre LM Studio offre un’interfaccia intuitiva per gestire modelli locali. La proposta Claris sembra voler combinare la semplicità del secondo con le capacità di clustering del primo.
Non è dato sapere quando debutterà la nuova proposta ma se Apple riuscirà davvero ad automatizzare configurazione, distribuzione dei modelli e gestione dei nodi, il principale progresso potrebbe essere proprio quello di rendere l’AI privata multi-Mac utilizzabile anche fuori dai laboratori e dagli ambienti riservati agli specialisti.


