Un archivio digitale contenente migliaia di fatture, contratti, ricevute e documenti personali è utile soltanto se permette di ritrovare rapidamente le informazioni. Paperless-ngx affronta il problema con un sistema open source di gestione documentale, installabile su un server domestico o aziendale. Ma cosa succede quando aggiungiamo un’AI capace di leggere i documenti, organizzarli e rispondere a domande sul loro contenuto? È proprio questo l’obiettivo di Paperless-AI, che aggiunge funzionalità avanzate di analisi semantica, classificazione e interrogazione dell’archivio.
Paperless-ngx nasce dall’evoluzione di Paperless e Paperless-ng, progetti dedicati alla digitalizzazione e all’archiviazione della documentazione cartacea. Come abbiamo spiegato nell’approfondimento sulle applicazioni self-hosted, permette di conservare i documenti sulla propria infrastruttura, mantenendo il controllo dei dati.
Come funziona Paperless-ngx e perché aggiungere l’intelligenza artificiale
Paperless-ngx acquisisce documenti da scanner, directory monitorate e altri canali di importazione, ne estrae il testo attraverso OCR e costruisce un indice ricercabile. Il software utilizza componenti come OCRmyPDF e Tesseract; supporta inoltre la classificazione automatica, l’assegnazione di etichette, il riconoscimento dei soggetti che hanno emesso o inviato i documenti, la gestione delle tipologie documentali e le regole di archiviazione. Paperless-AI si collega all’istanza esistente tramite API REST e ne amplia le capacità.
Il software può analizzare il contenuto di una fattura, assegnare un titolo significativo, individuare il mittente, proporre etichette e compilare campi personalizzati. La versione 4 supporta Paperless-ngx 2.x e 3.x, negoziando automaticamente la versione delle API.
Paperless-ngx 3 dispone già di funzioni AI opzionali, comprese proposte di classificazione, ricerca di documenti simili e conversazioni sui contenuti. Il vantaggio dell’estensione esterna risiede soprattutto nella maggiore articolazione dei flussi automatici, nelle opzioni OCR e negli strumenti dedicati alla gestione dell’analisi.
Paperless-AI 4.1 introduce PaddleOCR per leggere anche le scansioni difficili
La novità più interessante della versione 4.1.0 riguarda l’integrazione di PaddleOCR PP-OCRv5, eseguito in locale tramite ONNX Runtime. Il motore interviene quando Tesseract non restituisce testo utilizzabile, per esempio con fotografie di documenti, scansioni poco leggibili o pagine orientate male.
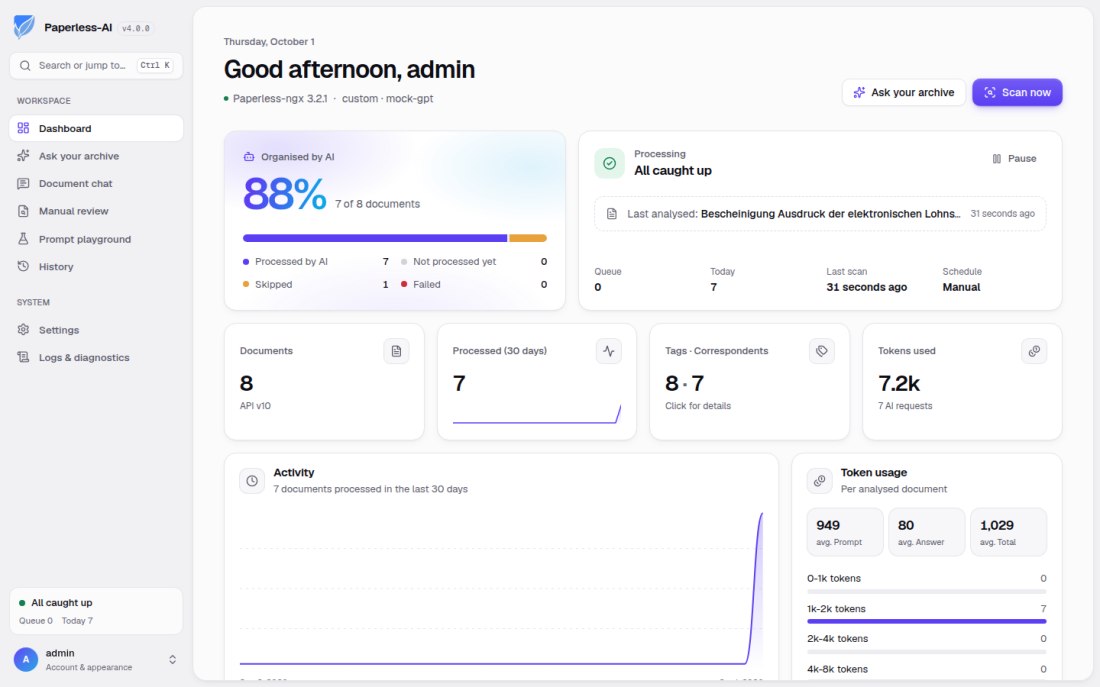
Il sistema calcola un punteggio indicativo della qualità del testo e può avviare il riconoscimento prima dell’elaborazione AI. Una nuova schermata permette di individuare i documenti problematici, elaborarne più di uno contemporaneamente e confrontare il testo originale con quello estratto da PaddleOCR.
Il risultato può sostituire il testo indicizzato in Paperless-ngx, migliorandone anche la ricerca full-text, con un’operazione del tutto reversibile.
I modelli richiedono circa 20 MB di download iniziale e l’elaborazione impiega indicativamente 1-2 secondi per pagina A4 su una CPU a 4 core.
È disponibile anche l’immagine Docker clusterzx/paperless-ai:latest-cuda per GPU NVIDIA, con CUDA 13 e driver dalla versione 580. Le prestazioni effettive dipendono comunque dall’hardware e dalla qualità delle scansioni.
Interrogare l’intero archivio: ricerca semantica e risposte con fonti
La riscrittura del progetto avviata con Paperless-AI 4.0 ha portato al rinnovamento del motore RAG (Retrieval-Augmented Generation).
Il programma suddivide il contenuto dei documenti in porzioni di testo e combina due tecniche di ricerca complementari. La prima, basata sull’algoritmo BM25, individua i passaggi che contengono le parole cercate, valutandone la rilevanza. La seconda utilizza gli embedding, rappresentazioni numeriche del significato dei testi, per trovare informazioni pertinenti anche quando i documenti utilizzano termini diversi da quelli inseriti nella domanda.
Ad esempio, cercando “spese per l’energia elettrica“, il sistema può recuperare anche una bolletta che riporta soltanto espressioni come “fornitura luce” o “consumi fatturati“. La combinazione delle due tecniche permette di ottenere risultati più completi rispetto alla semplice ricerca per parole chiave e di fornire al modello AI i passaggi utili per elaborare una risposta.
Possiamo chiedere quanto abbiamo pagato con l’ultima bolletta elettrica oppure individuare contratti che citano una determinata clausola. Le risposte arrivano progressivamente e includono riferimenti ai documenti utilizzati. Filtri per data, corrispondente e tipologia aiutano a circoscrivere le ricerche; l’indice si aggiorna in modo incrementale.
Paperless-AI supporta Ollama per l’esecuzione locale dei modelli, oltre a OpenAI, Anthropic, Azure OpenAI e servizi con API compatibili. Un nuovo assistente di configurazione dei prompt permette di definire lingua, formato dei titoli, regole di classificazione e gestione delle etichette, verificando il risultato su documenti reali prima di applicarlo.
Architettura più leggera, privacy e sicurezza: cosa cambia
La versione 4 ha sostituito la precedente architettura Node.js e Python con un’applicazione TypeScript basata su un unico processo Node.js: l’immagine compressa occupa così circa 135 MB e il consumo di RAM a riposo si colloca indicativamente fra 80 e 150 MB, contro 1-2 GB della generazione precedente.
Il sistema conserva una cronologia delle modifiche che permette di ripristinare i metadati originali; supporta inoltre webhook (che permettono di notificare automaticamente ad altre applicazioni il verificarsi di determinati eventi, ad esempio il completamento dell’analisi di un documento, così da attivare ulteriori operazioni senza intervento manuale), elaborazione automatica e limitazioni ai tag e ai soggetti che hanno emesso o inviato i documenti già presenti nell’archivio.
Infine, dal punto di vista della privacy, utilizzare Ollama e OCR locale consente di evitare l’invio dei contenuti a servizi AI esterni. Se invece si configura un provider cloud, i documenti analizzati possono raggiungere infrastrutture di terze parti.
Come installare Paperless-AI con Docker e collegarlo a Paperless-ngx
Per provare Paperless-AI 4.1 non serve modificare l’installazione esistente di Paperless-ngx: l’applicazione funziona come servizio autonomo e comunica con il sistema di gestione documentale attraverso le API. Il metodo più semplice consiste nell’utilizzare Docker, creando un container dedicato e un volume persistente per conservare configurazioni e dati.
Su un server Linux con Docker già installato, possiamo avviare Paperless-AI con il seguente comando:
docker run -d \
  --name paperless-ai \
  --restart unless-stopped \
  -p 3000:3000 \
  -v paperless-ai_data:/app/data \
  clusterzx/paperless-ai:4.1.0
Al termine, basta aprire il browser all’indirizzo http://IP_DEL_SERVER:3000 per accedere alla procedura guidata. Il programma richiede la creazione di un account amministrativo, l’indirizzo dell’istanza Paperless-ngx e il relativo token API, recuperabile dalle impostazioni del proprio profilo Paperless-ngx.
Se Paperless-ngx e Paperless-AI funzionano in container differenti, localhost indica il container corrente, non il server Paperless-ngx. Bisogna quindi utilizzare un indirizzo raggiungibile dal container, per esempio http://paperless-webserver:8000 quando entrambi condividono una rete Docker con risoluzione dei nomi attiva.
La configurazione prosegue con la scelta del provider AI. Chi preferisce mantenere i documenti sulla propria infrastruttura può utilizzare Ollama con un modello locale; in alternativa, è possibile configurare OpenAI, Anthropic o altri servizi compatibili. Dall’interfaccia si definiscono anche le regole di classificazione e le modalità di elaborazione dei documenti.
Per sfruttare l’accelerazione NVIDIA nelle attività OCR, si può utilizzare l’immagine latest-cuda, configurando il container per l’accesso alla GPU mediante NVIDIA Container Toolkit. La variante standard funziona invece sulla CPU, senza richiedere una scheda video dedicata. È consigliabile completare la configurazione mantenendo la porta 3000 accessibile soltanto dalla rete locale.
La documentazione ufficiale di Paperless-AI raccomanda di non esporre direttamente il servizio su Internet senza ulteriori protezioni, come una VPN o un reverse proxy con autenticazione.
La vulnerabilità critica delle vecchie versioni e il ritorno dello sviluppatore
Lo sviluppatore di Paperless-AI ha spiegato le ragioni della lunga inattività del progetto: impegni familiari, difficoltà personali e un codice diventato progressivamente difficile da mantenere. La riscrittura, annunciata a gennaio 2026, ha richiesto mesi di programmazione, debugging e utilizzo di strumenti AI per assistere lo sviluppo.
Il rilascio ha assunto particolare urgenza dopo la scoperta di una vulnerabilità critica, valutata dallo sviluppatore con punteggio CVSS 9,8. Nelle versioni precedenti alla 4.0, la procedura di configurazione risultava accessibile senza autenticazione: un attaccante capace di raggiungere l’istanza poteva sostituire account e impostazioni, compreso il token di accesso a Paperless-ngx.
Chi utilizza Paperless-AI 3.x dovrebbe quindi aggiornare immediatamente alla nuova versione, controllare l’eventuale esposizione pubblica dell’istanza e valutare la rotazione delle credenziali e dei token. Per chi gestisce documenti riservati, resta fondamentale limitare gli accessi di rete e mantenere backup indipendenti.
Paperless-AI 4.1 rappresenta insomma un ampliamento interessante delle capacità di Paperless-ngx, soprattutto per archivi numerosi e scansioni imperfette. In ogni caso, le classificazioni suggerite dall’AI richiedono sempre verifiche, specialmente quando riguardano documentazione amministrativa o contrattuale.