

Scriviamo www.ilsoftware.it nella barra degli indirizzi di Chrome, Firefox o Edge, premiamo Invio e, una frazione di secondo più tardi, vediamo apparire la pagina web richiesta: il browser contatta un server, scarica i contenuti e li mostra sullo schermo. In realtà, dietro quel gesto si nasconde una catena di decisioni e operazioni molto più articolata.
Prima ancora di stabilire una connessione, il browser deve interpretare ciò che abbiamo digitato, capire se si tratta di un indirizzo o di una ricerca, stabilire quale protocollo utilizzare e individuare il sistema remoto da contattare.
Entrano poi in gioco la risoluzione DNS, la scelta tra IPv4 e IPv6, l’apertura della connessione, la negoziazione crittografica, il trasferimento dei dati e l’elaborazione di HTML, CSS e JavaScript. Non tutti questi passaggi, inoltre, si ripetono a ogni visita di un sito web: alcuni possono essere evitati grazie alle cache, altri possono svolgersi in parallelo e altri ancora iniziano addirittura prima che premiamo Invio.
Il browser controlla se vogliamo visitare un sito o effettuare una ricerca
La barra degli indirizzi dei browser che utilizziamo oggi non serve soltanto a inserire URL: è anche un campo di ricerca, un’interfaccia per accedere alla cronologia e uno strumento che propone completamenti sulla base dei siti già visitati.
Se digitiamo www.ilsoftware.it, il browser riconosce la forma di un nome di dominio e può interpretarlo come destinazione web. Se invece scriviamo una frase, ad esempio una richiesta come la si introdurrebbe in un motore di ricerca, il browser trasferirà la query a Google, Bing, DuckDuckGo e così via (a seconda della preferenza espressa dell’utente).
Non sempre la distinzione è immediata: la stringa associata a un server locale, un nome di host aziendale oppure una parola contenente un punto possono richiedere regole specifiche, soprattutto quando entrano in gioco reti intranet e domini configurati in locale.
Una volta premuto Invio, il browser determina l’URL effettivo, identifica il nome dell’host, la porta, l’eventuale percorso e gli altri componenti.
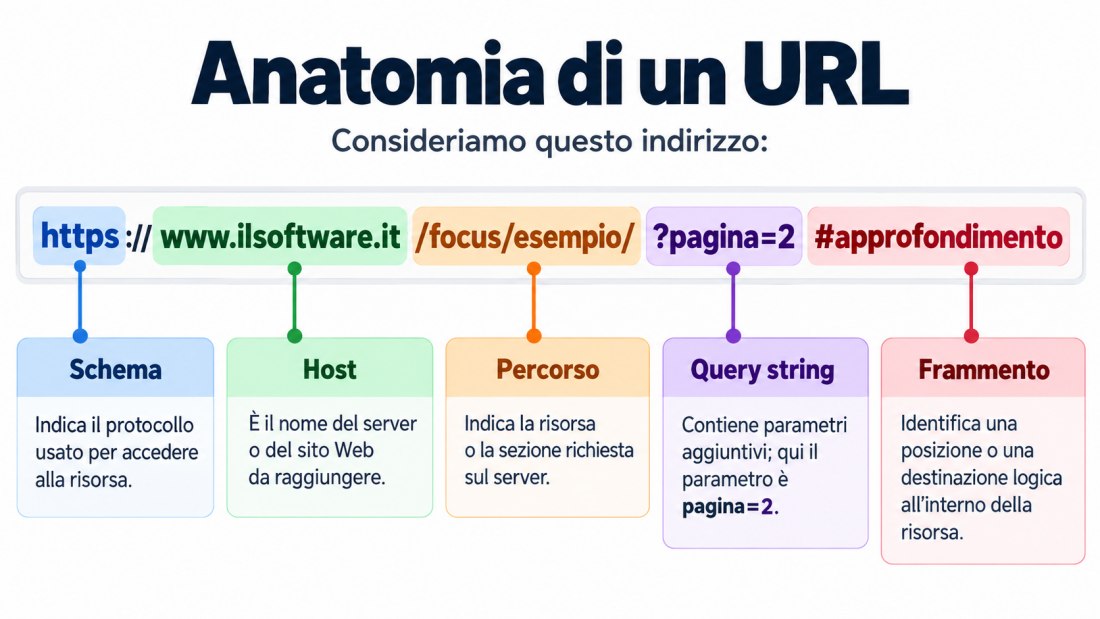
L’eventuale frammento, che segue il simbolo #, identifica una posizione o una destinazione logica all’interno della risorsa (i.e. pagina web). Il browser non lo include nella richiesta HTTP inviata al server: può utilizzarlo per raggiungere una sezione del documento o renderlo disponibile agli script della pagina, ma la componente successiva al simbolo # non fa parte del messaggio HTTP destinato al server.
Il browser decide se usare HTTPS
Quando inseriamo soltanto www.ilsoftware.it, senza specificare http:// oppure https://, il browser tende oggi a privilegiare una connessione HTTPS.
Se il dominio utilizza HSTS (HTTP Strict Transport Security), il browser può sapere, grazie a una regola memorizzata durante una visita precedente o già inclusa al suo interno, che deve collegarsi esclusivamente tramite HTTPS, evitando qualsiasi tentativo di connessione HTTP non cifrata.
HSTS si configura sul server web, che invia al browser l’intestazione HTTP Strict-Transport-Security nelle risposte HTTPS, specificando per quanto tempo il dominio deve essere raggiunto esclusivamente tramite connessioni sicure ed eventualmente estendendo la regola ai sottodomini.
Se invece tale indicazione manca, il browser può comunque provare inizialmente HTTPS, adottando le proprie regole per gestire un eventuale fallimento. Le modalità di ripiego verso HTTP dipendono dalle impostazioni e non sono sempre consentite, soprattutto quando l’utente attiva protezioni che richiedono connessioni sicure.
Nel primo caso appena citato, il browser sceglie direttamente HTTPS, senza comunicare preliminarmente con il sito via HTTP. Nel secondo, il browser riceve un vero reindirizzamento HTTP, per esempio una risposta con codice 301 o 308, che indica di ripetere la richiesta usando un altro URL. Un reindirizzamento richiede una risposta da parte di un server; una decisione locale del browser può evitare del tutto quel passaggio.
DNS: come il browser scopre dove si trova il sito
Per contattare un servizio remoto occorre individuare l’indirizzo IP della destinazione. Il nome www.ilsoftware.it è per noi familiare ma da solo non permette di indirizzare i pacchetti attraverso Internet. Il resolver DNS (Domain Name System) permette appunto di risolvere la corrispondenza tra l’indirizzo mnemonico (come www.ilsoftware.it) e l’indirizzo IP pubblico utilizzato dal sistema che deve essere raggiunto.
Ogni volta che premiamo Invio nella barra degli indirizzi, però, il browser non interroga sempre un server DNS remoto: la risoluzione può utilizzare informazioni già disponibili nella cache del browser, nel sistema operativo o nel resolver ricorsivo. In alcuni casi intervengono anche configurazioni locali, come il file HOSTS, regole aziendali o meccanismi di risoluzione specifici della rete.
Le modalità e l’ordine delle verifiche variano secondo l’implementazione: non esiste una sequenza rigida identica per tutti i browser e tutti i sistemi operativi.
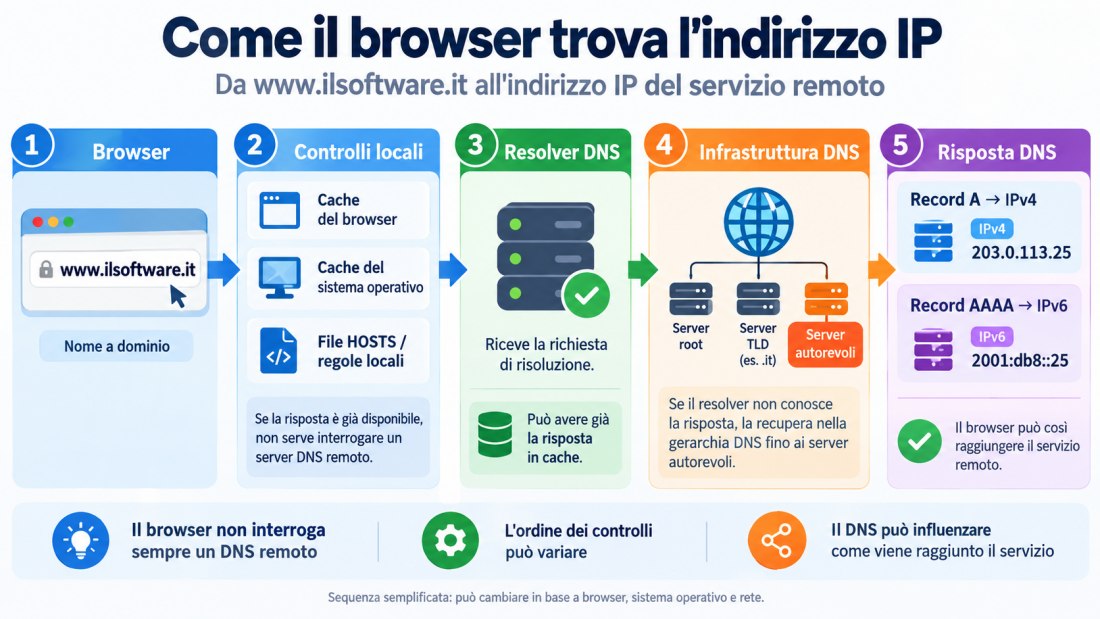
Quando serve effettivamente una risoluzione DNS, il browser o il sistema operativo si rivolgono a un resolver. Se quest’ultimo non possiede già la risposta, può recuperarla attraverso l’infrastruttura DNS, arrivando eventualmente ai server autorevoli per il dominio.
La risposta può contenere indirizzi IPv4, attraverso record A, oppure indirizzi IPv6, mediante record AAAA. Il DNS può non limitarsi a restituire sempre un unico indirizzo IP: può contribuire anche alle decisioni con cui il browser stabilisce come raggiungere il servizio remoto.
Perché cambiare DNS non rende automaticamente più veloce un sito
I puristi sono spesso soliti cercare un resolver DNS che offra le migliori prestazioni possibili. La cosa ha senso perché se un server DNS, magari raggiungibile con pochi passaggi, restituisce la corrispondenza tra nome di dominio e IP molto velocemente, si può riscontare un piccolo guadagno in termini di performance.
Va osservato, però, che la risoluzione del nome rappresenta soltanto una parte del tempo necessario per caricare una pagina.
Un resolver particolarmente rapido può ridurre il ritardo iniziale, soprattutto quando il risultato non è già disponibile nella cache. Ma se il server del sito web impiega molto tempo a generare la risposta, la rete presenta un’elevata latenza oppure la pagina utilizza codice JavaScript particolarmente pesante (ne parliamo più avanti), cambiare DNS può produrre benefici trascurabili.
Il server DNS può restituire indirizzi IP diversi per lo stesso dominio, anche in base alla posizione geografica dell’utente o del resolver utilizzato. Di conseguenza, cambiare DNS può portare il browser a collegarsi a un nodo CDN differente, magari più vicino o più lontano, influenzando così la velocità di caricamento del sito.
Il DNS può quindi incidere sulle prestazioni in due modi distinti: attraverso il tempo impiegato per risolvere il nome e, in alcune architetture, attraverso la scelta del server che distribuisce i contenuti.
L’indirizzo IP non identifica necessariamente il server che contiene il sito
Una volta ottenuti uno o più indirizzi IP con la risoluzione DNS, il browser dispone delle informazioni necessarie per tentare la connessione.
Molti servizi web utilizzano CDN (Content Delivery Network), reverse proxy, bilanciatori di carico e infrastrutture distribuite geograficamente. L’indirizzo IP restituito dal DNS può appartenere a un nodo periferico che riceve la richiesta, applica controlli di sicurezza, recupera i contenuti da un server di origine e restituisce la risposta al client. In molti casi, ancora, lo stesso indirizzo IP ospita numerosi siti web differenti.
La destinazione non dipende quindi soltanto dall’indirizzo IP: il nome del sito richiesto continua ad avere un ruolo fondamentale anche dopo la risoluzione DNS perché il nome di dominio è proprio parte integrante della richiesta HTTP avanzata dal browser.
La rete, nel frattempo, deve trasportare i pacchetti fino alla destinazione. Sul computer entra in gioco la tabella di routing, che permette di stabilire quale interfaccia di rete e quale gateway utilizzare. A livello locale, protocolli come ARP per IPv4 e Neighbor Discovery per IPv6 contribuiscono a raggiungere il dispositivo successivo.
Da lì, i router presenti lungo il percorso instradano i pacchetti verso la rete che annuncia la raggiungibilità dell’indirizzo IP di destinazione.
Una connessione web spesso non attraversa mezzo pianeta: proprio grazie all’uso delle CDN e agli accordi di interconnessione tra operatori, il server che risponde potrebbe trovarsi in un data center fisico vicino alla posizione dell’utente (migliorando quindi le prestazioni).
TCP o QUIC: il browser deve stabilire come comunicare
Conosciuto l’endpoint ovvero il sistema remoto da raggiungere, resta da scegliere il meccanismo di trasporto da utilizzare.
Per le connessioni HTTP/1.1 e HTTP/2 sopra HTTPS, il browser si affida normalmente a TCP: il protocollo stabilisce una connessione attraverso il cosiddetto three-way handshake, uno scambio iniziale di tre messaggi:
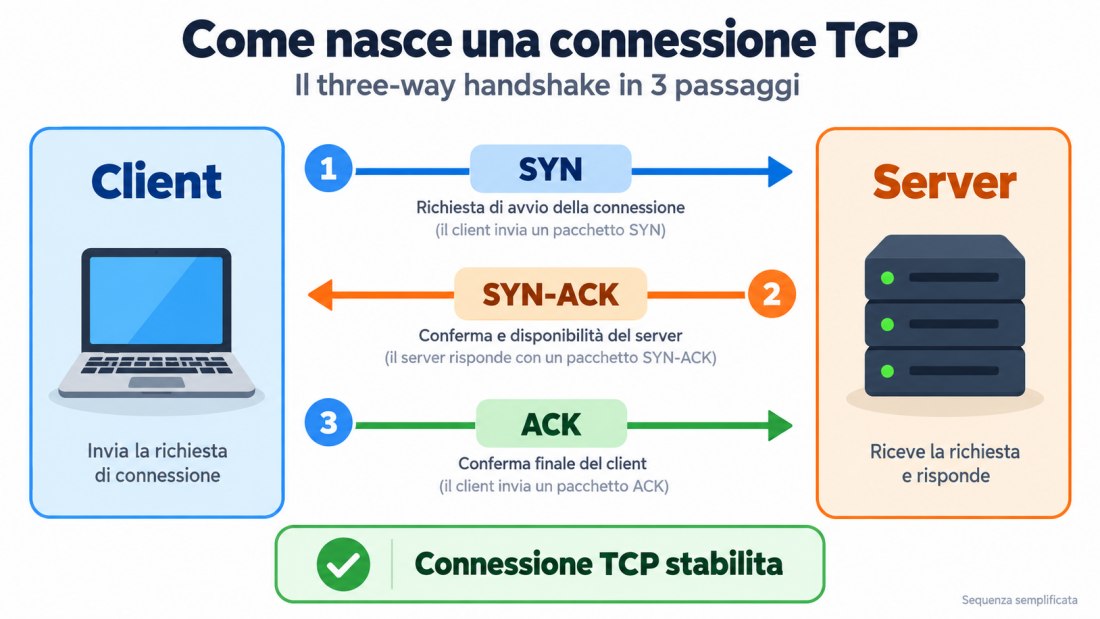
Il primo messaggio chiede di avviare la comunicazione, il secondo conferma la disponibilità del server e il terzo completa la procedura.
TCP offre un flusso affidabile e ordinato per quanto riguarda lo scambio dei pacchetti occupandosi di ritrasmissioni, controllo dei pacchetti persi e dell’eventuale congestione.
Se invece viene utilizzato HTTP/3, il trasporto cambia radicalmente: HTTP/3 si basa su QUIC, costruito sopra il protocollo UDP, aggiunge meccanismi di affidabilità, controllo della congestione, gestione dei flussi e protezione crittografica. QUIC combina l’avvio della connessione con la negoziazione TLS 1.3, riducendo in molte circostanze il numero di scambi necessari prima di trasferire i dati applicativi.
QUIC può velocizzare ulteriormente l’apertura di una connessione quando browser e server hanno già comunicato in precedenza. Grazie al meccanismo 0-RTT (Zero Round Trip Time), il browser può inviare alcuni dati immediatamente, senza attendere il completamento della nuova negoziazione crittografica. Il vantaggio consiste nel risparmiare un tempo di andata e ritorno dei messaggi sulla rete (round trip time). Il meccanismo richiede però particolari precauzioni: i dati inviati anticipatamente potrebbero essere intercettati e ritrasmessi da un attaccante (replay attack), motivo per cui il server deve applicare adeguate protezioni e limitare le operazioni consentite.
HTTP/3, tuttavia, non è necessariamente più veloce di HTTP/2. Come abbiamo spiegato nell’articolo HTTP/3 non è più veloce del predecessore: ecco quando, uno studio presentato alla ACM Web Conference 2024 ha evidenziato che, su connessioni stabili e ad alta velocità, HTTP/2 può ottenere prestazioni superiori. QUIC introduce infatti un carico di elaborazione aggiuntivo, soprattutto nella gestione dei pacchetti e delle conferme di ricezione, che in determinate condizioni può ridurre i vantaggi offerti dal protocollo.
La crittografia TLS: il browser deve verificare con chi sta parlando
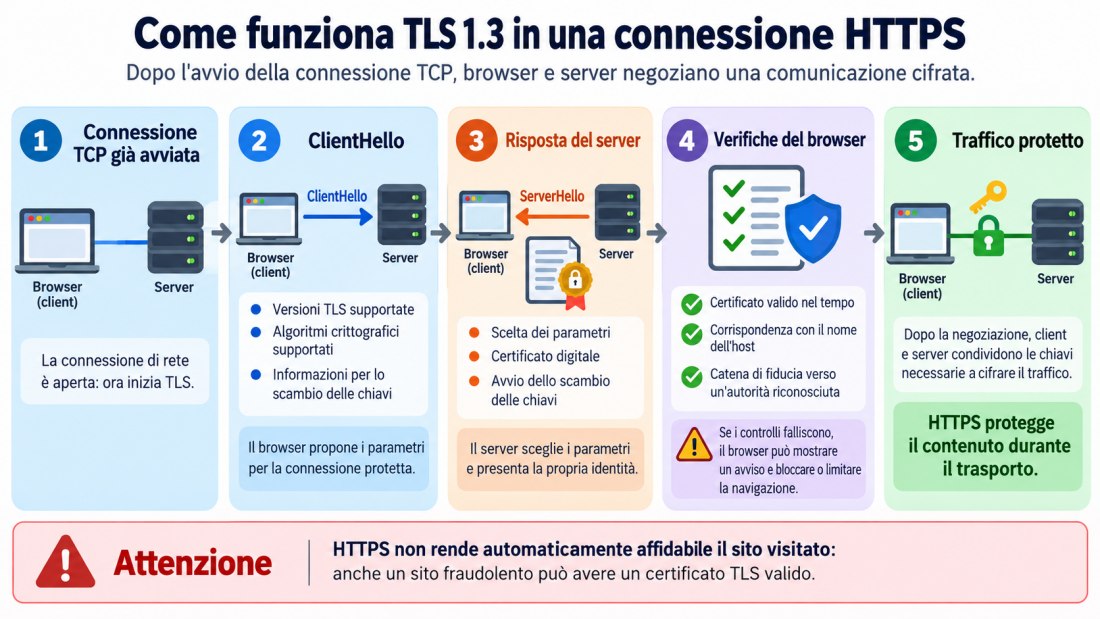
Per le connessioni HTTPS che utilizzano TCP, dopo l’avvio della connessione si passa alla gestione del protocollo TLS che protegge lo scambio dei dati con la crittografia.
Con TLS 1.3 il browser e il server negoziano i parametri necessari alla comunicazione protetta: il client trasmette generalmente un messaggio ClientHello, che include le versioni e gli algoritmi crittografici supportati nonché le informazioni necessarie per lo scambio delle chiavi.
Il server risponde con le proprie scelte e presenta, quando previsto, il certificato digitale che permette al browser di autenticarne l’identità.
Il client controlla la validità temporale del certificato, la corrispondenza con il nome dell’host richiesto e la catena di fiducia che conduce a un’autorità riconosciuta. Si aggiungono altri controlli previsti dall’implementazione e dalle politiche di sicurezza.
Se le verifiche richieste falliscono, il browser può mostrare un avviso e impedire o limitare la prosecuzione della navigazione; una volta completata la negoziazione, client e server dispongono delle chiavi necessarie a proteggere il traffico.
HTTPS protegge il contenuto della comunicazione durante il trasporto, ma non rende automaticamente affidabile il sito visitato: anche un sito fraudolento può possedere un certificato TLS perfettamente valido.
Il nome del sito può essere visibile anche quando usiamo HTTPS
La crittografia alla base del funzionamento di HTTPS protegge il percorso e i parametri della richiesta HTTP, il contenuto trasferito e molti altri dati applicativi. Non tutte le informazioni usate per stabilire la connessione sono però nascoste.
L’indirizzo IP di destinazione rimane normalmente osservabile sulla rete; inoltre, nei collegamenti TLS tradizionali, il campo SNI (Server Name Indication) del messaggio iniziale può rivelare il nome dell’host che il client desidera raggiungere.
La tecnologia ECH (Encrypted ClientHello) è progettata per cifrare anche le informazioni sensibili del messaggio ClientHello, compreso il nome effettivo dell’host. La sua disponibilità pratica dipende però dal browser, dal server e dalla configurazione della connessione.
Analogamente, l’utilizzo di DNS over HTTPS o DNS over TLS proteggono il contenuto delle interrogazioni DNS lungo il tratto verso il resolver scelto, senza rendere invisibile l’intera attività di navigazione.
La richiesta HTTP: pochi byte avviano il caricamento della pagina web
Quando dispone di una connessione utilizzabile, il browser può finalmente richiedere la risorsa. Per una tradizionale attività di navigazione, l’operazione più comune è una richiesta HTTP con metodo GET. In una rappresentazione semplificata di HTTP/1.1, il messaggio potrebbe apparire così:
GET / HTTP/1.1

Host: www.ilsoftware.it

Accept: text/html

Accept-Language: it-IT,it;q=0.9

User-Agent: ...
La prima riga specifica il metodo, il percorso richiesto e la versione del protocollo; il campo Host identifica il sito desiderato, mentre gli altri header forniscono informazioni sulle preferenze del client e sui formati accettati.
HTTP/2 e HTTP/3 utilizzano invece rappresentazioni binarie, compressione degli header e pseudointestazioni, quindi non trasmettono letteralmente questo stesso blocco testuale.
La richiesta può includere anche cookie associati al sito, header relativi alla cache, informazioni sull’origine della navigazione e altri metadati. La loro presenza dipende dalle impostazioni del browser, dalle caratteristiche della richiesta e dalle restrizioni di sicurezza e privacy.
A questo punto, il server deve decidere come rispondere: può restituire un documento HTML già pronto, eseguire un’applicazione che interroga un database, contattare servizi interni oppure rispondere direttamente da una cache. Come osservato in precedenza, non tutte le richieste possono raggiungere il server di origine: un reverse proxy o una CDN possono soddisfarle in autonomia.
La risposta comprende un codice di stato, una serie di intestazioni e, quando previsto, un corpo contenente i dati richiesti. Ad esempio:
HTTP/1.1 200 OK
Content-Type: text/html; charset=utf-8
Cache-Control: public, max-age=300
Content-Encoding: gzip

<!doctype html>
<html lang="it">
...
</html>
Il codice 200 indica che la richiesta è riuscita. Una risposta 301 o 308 possono disporre un reindirizzamento permanente, un 404 segnala che la risorsa non è stata trovata e un 503 indica che il servizio non è temporaneamente disponibile.
Se il server restituisce un 304 Not Modified, invece, il browser può riutilizzare una rappresentazione precedentemente memorizzata nella cache, secondo le regole della validazione HTTP.
Dall’HTML ai pixel: come il browser costruisce la pagina
Ricevuto il documento HTML, il browser comincia ad analizzarne il contenuto. Non deve attendere che il download termini: può iniziare a interpretare i dati mentre arrivano dalla rete.
Il parser HTML riconosce gli elementi del documento e costruisce una rappresentazione strutturata chiamata DOM, acronimo di Document Object Model. Il DOM è una struttura ad albero che descrive gli elementi del documento, le relazioni tra di essi e le modifiche che gli script possono apportare durante l’esecuzione.
Prendiamo un frammento molto semplice:
<html>

<body>

<h1>Benvenuto</h1>

<p>Questa è una pagina Web.</p>

</body>

</html>
Il browser costruisce una gerarchia nella quale l’elemento html contiene body, che a sua volta ospita un titolo e un paragrafo. Contemporaneamente, il browser identifica le risorse esterne necessarie alla pagina: fogli di stile CSS, immagini, script JavaScript, caratteri tipografici e altri contenuti.
Una pagina web non corrisponde quasi mai a una singola richiesta HTTP: il documento iniziale può innescare decine o centinaia di richieste aggiuntive, anche verso domini differenti. Un foglio CSS può richiedere il download di font; uno script può interrogare API remote; un’immagine può essere distribuita da una CDN e un video può provenire da un servizio esterno.
JavaScript può ritardare la comparsa della pagina anche quando la rete è veloce
L’HTML descrive la struttura e i CSS stabiliscono la presentazione, ma buona parte delle applicazioni web moderne affida a JavaScript una porzione significativa delle proprie funzionalità. Il parser HTML può incontrare uno script che modifica il documento, genera nuovi elementi o richiede dati aggiuntivi al server.
Uno script classico esterno, privo di attributi particolari, può interrompere temporaneamente il parsing HTML mentre il browser lo recupera e lo esegue; il comportamento dipende anche dalla presenza di risorse CSS che lo script deve attendere.
Gli attributi async e defer modificano le modalità di caricamento ed esecuzione degli script, permettendo di ridurre alcuni blocchi. Gli script JavaScript di tipo modulo seguono regole proprie e, in generale, non bloccano il parser HTML come uno script classico privo di attributi.
Alcuni siti consegnano al browser un documento HTML già ricco di contenuti; altri trasmettono una struttura iniziale essenziale e affidano a JavaScript il compito di recuperare e costruire buona parte dell’interfaccia.
Nel secondo caso, il server può rispondere rapidamente, ma la pagina apparire vuota o incompleta finché non terminano il caricamento e l’esecuzione degli script necessari.
Occorre perciò distinguere tre momenti diversi: quando il server comincia a rispondere, quando il contenuto diventa visibile e quando l’interfaccia risponde alle azioni dell’utente.
Il browser può iniziare a lavorare prima di ricevere tutta la pagina
I motori dei browser, come già accennato in precedenza, non si limitano ad analizzare l’HTML in maniera sequenziale. Un componente spesso indicato come preload scanner cerca anticipatamente riferimenti a risorse potenzialmente necessarie, così da avviare alcuni download senza attendere che il parser principale raggiunga ogni elemento del documento. Gli sviluppatori possono inoltre inserire indicazioni specifiche:
<link rel="preconnect"
href="https://static.example.com">

<link rel="preload"
href="/fonts/inter.woff2"
as="font"
type="font/woff2"
crossorigin>
Nel primo caso il browser riceve un suggerimento per preparare anticipatamente una connessione verso un’origine. Nel secondo può recuperare in anticipo una risorsa che sarà usata in seguito. Spetta al browser decidere come attenersi alle indicazioni considerando priorità, risorse disponibili e condizioni della navigazione.
Tecniche come il lazy loading consentono di rinviare il caricamento di alcune immagini o altri elementi fino a quando diventano necessarie, operazione utile anche per migliorare i parametri Google Vitals. Il caricamento della pagina è quindi un insieme di attività contemporanee, con dipendenze e priorità differenti.
Cache e Service Worker: a volte il browser non ha bisogno della rete
Finora abbiamo seguito il percorso di una navigazione che richiede effettivamente l’accesso a un server remoto. Ma cosa accade quando torniamo su una pagina già visitata?
Il browser potrebbe recuperare alcune risorse dalla propria cache HTTP, evitando il trasferimento dei dati o limitandosi a verificarne la validità.
Le intestazioni HTTP, come Cache-Control, ETag e Last-Modified, contribuiscono a stabilire per quanto tempo una rappresentazione può essere riutilizzata e come effettuare eventuali richieste condizionali.
La cache, però, non è l’unico meccanismo disponibile: un sito può registrare un Service Worker, uno script che opera separatamente dalla pagina e che, se attivo e autorizzato a controllare la navigazione, può intercettare determinate richieste e decidere come soddisfarle. Può ad esempio restituire una risorsa memorizzata attraverso la Cache API, richiederne una versione aggiornata oppure combinare dati locali e contenuti remoti.
Un’applicazione web progettata per funzionare offline può quindi mostrare contenuti anche quando la connessione Internet non è disponibile.
Esiste poi la Back/Forward Cache, o BFCache, che in condizioni favorevoli permette di ripristinare una pagina quando utilizziamo i comandi Indietro e Avanti nell’interfaccia del browser. In questo caso il browser può conservare una rappresentazione dello stato della pagina, evitando una nuova navigazione completa.
Perché un sito può impiegare cinque secondi ad aprirsi con una fibra velocissima
Un collegamento ultrabroadband da 1 Gbps non garantisce che ogni sito venga visualizzato immediatamente. La velocità nominale della connessione esprime la capacità di trasferimento dati, ma il caricamento di una pagina dipende anche da altri fattori: latenza, tempi di elaborazione del server, negoziazione delle connessioni, dimensioni delle risorse e lavoro richiesto alla CPU del dispositivo.
Immaginiamo due siti:
- Il primo trasferisce 500 KB di HTML e immagini ottimizzate, ma il server impiega due secondi a generare la risposta iniziale. In questo caso il problema è essenzialmente lato server.
- Il secondo restituisce immediatamente l’HTML, ma carica diversi megabyte di JavaScript che richiedono elaborazioni particolarmente pesanti. Qui il sito potrebbe soffrire di un problema di trasferimento dati, elaborazione locale o entrambi.
Per individuare la causa, è utile conoscere alcune metriche:
- TTFB (Time To First Byte) misura il tempo trascorso prima della ricezione del primo byte della risposta, includendo le componenti pertinenti alla richiesta e alla connessione.
- LCP (Largest Contentful Paint) misura quando termina il rendering dell’elemento di contenuto più grande rilevante nell’area visibile della pagina.
- INP (Interaction to Next Paint) valuta la reattività alle interazioni dell’utente.
Un buon TTFB non garantisce un buon LCP; un buon LCP non assicura automaticamente un INP soddisfacente. Una pagina può dunque apparire rapidamente ma rispondere lentamente ai clic, oppure richiedere molto tempo prima di mostrare il contenuto principale pur diventando successivamente molto fluida.
Come vedere tutto quello che succede premendo Invio
La parte più interessante è il browser permette di investigare molti dei meccanismi descritti, senza installare programmi aggiuntivi. Chrome, Edge e Firefox includono strumenti di sviluppo che permettono di analizzare il traffico HTTP, i tempi di caricamento e il comportamento della pagina.
Apriamo il browser, premiamo F12 e selezioniamo la scheda Network (Rete); attiviamo l’opzione Preserve log/Keep per conservare le richieste durante gli eventuali reindirizzamenti e la navigazione; digitiamo quindi un indirizzo nella barra del browser e premiamo Invio.
Nella scheda Network compariranno le richieste effettuate durante la navigazione, ciascuna associata a informazioni come URL, codice di stato, dimensione dei dati trasferiti, tipologia della risorsa e durata. Selezionando la richiesta principale del documento HTML, possiamo esaminare le intestazioni inviate dal browser, quelle restituite dal server e una suddivisione dei tempi.
Per una richiesta che presuppone una nuova connessione, gli strumenti di sviluppo possono mostrare fasi come:
- Queueing. Attesa prima dell’avvio della richiesta.
- DNS Lookup. Risoluzione del nome a dominio.
- Initial connection. Impostazione della connessione.
- SSL. Negoziazione della connessione TLS.
- Waiting (TTFB). Attesa del primo byte della risposta.
- Content Download. Ricezione del corpo della risposta.
Se il browser riutilizza una connessione esistente, per esempio, non dovrà ripetere DNS, TCP e TLS per ogni richiesta. Inoltre, alcune durate possono sovrapporsi e non vanno sommate meccanicamente.
Se la barra Waiting occupa quasi tutto il tempo, è possibile che il problema riguardi l’attesa della risposta del server o di un intermediario. Se prevale Content Download, conviene analizzare le dimensioni delle risorse e il throughput effettivo.
Per approfondire i problemi di rendering e JavaScript, la scheda Performance degli strumenti di sviluppo consente invece di registrare l’attività del browser e individuare operazioni particolarmente costose per la CPU.
La pagina è visibile, ma il browser può continuare a lavorare
Un ultimo aspetto merita attenzione: il caricamento di un sito non coincide sempre con un’operazione che inizia premendo Invio e termina quando vediamo la pagina.
Anche dopo la comparsa del contenuto principale, il browser può continuare a recuperare immagini, eseguire script, effettuare richieste API, aggiornare dati e mantenere connessioni aperte.
Alcune applicazioni utilizzano WebSocket o altri meccanismi che permettono di ricevere aggiornamenti senza ricaricare la pagina o svolgere operazioni attive.
I documenti web prevedono eventi come DOMContentLoaded, che segnala il completamento del parsing HTML e dell’esecuzione degli script differiti, e load, che attende anche il completamento di ulteriori risorse previste dal modello di caricamento. Nessuno dei due garantisce però che tutte le attività di rete future siano terminate, né che l’applicazione sia completamente pronta a rispondere alle interazioni.
È uno dei motivi per cui gli strumenti di analisi delle prestazioni osservano indicatori diversi invece di affidarsi a un singolo tempo di caricamento.
Conclusioni: un gesto semplice, decine di decisioni
Digitare un indirizzo e premere Invio significa affidare al browser una serie di operazioni coordinate: interpretare l’URL, individuare la destinazione, scegliere il protocollo, proteggere la comunicazione, richiedere i contenuti e trasformarli in un’interfaccia visibile.
Il browser non deve sempre ripetere l’intera procedura a ogni navigazione: cache DNS, connessioni persistenti, HTTP/2, HTTP/3 e memorizzazione locale delle risorse permettono di saltare alcuni passaggi o di eseguirli in parallelo, riducendo i tempi di attesa.
Comprendere il funzionamento di questi meccanismi aiuta anche a interpretare meglio le prestazioni dei siti web. Una pagina lenta può dipendere sì da una connessione Internet poco veloce ma potrebbe essere avere origine dalla latenza, dai tempi di risposta del server, dal trasferimento delle risorse o dal lavoro che il browser deve svolgere per elaborarle e visualizzarle.


